


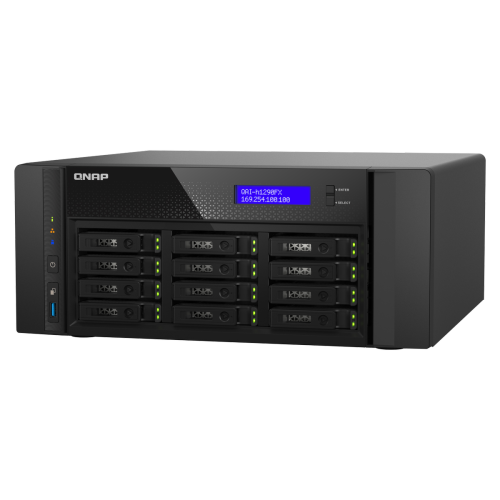
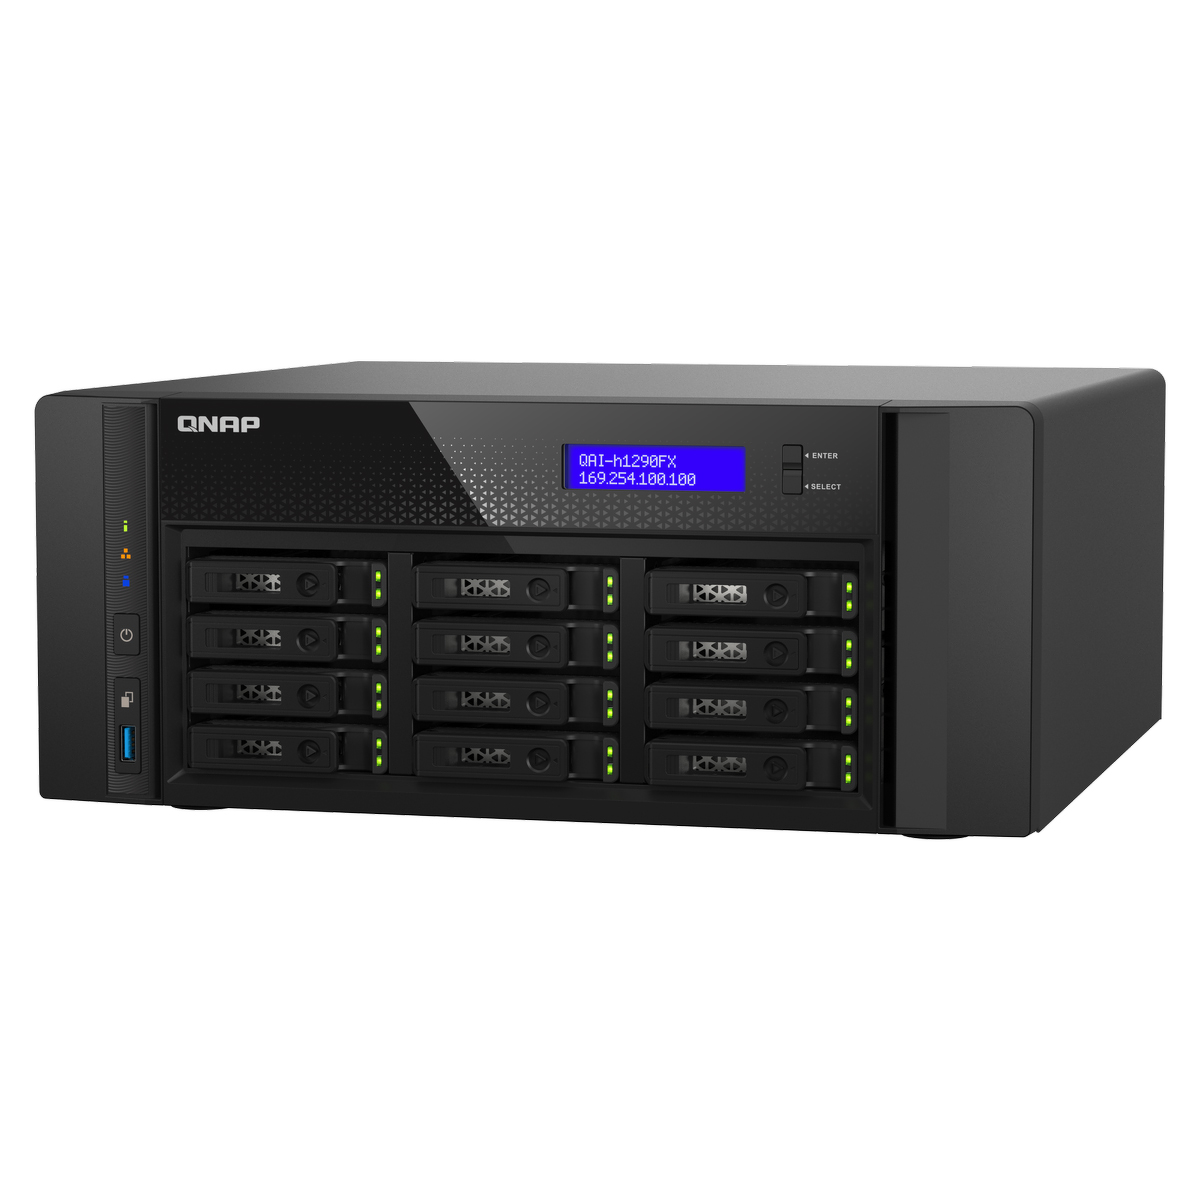
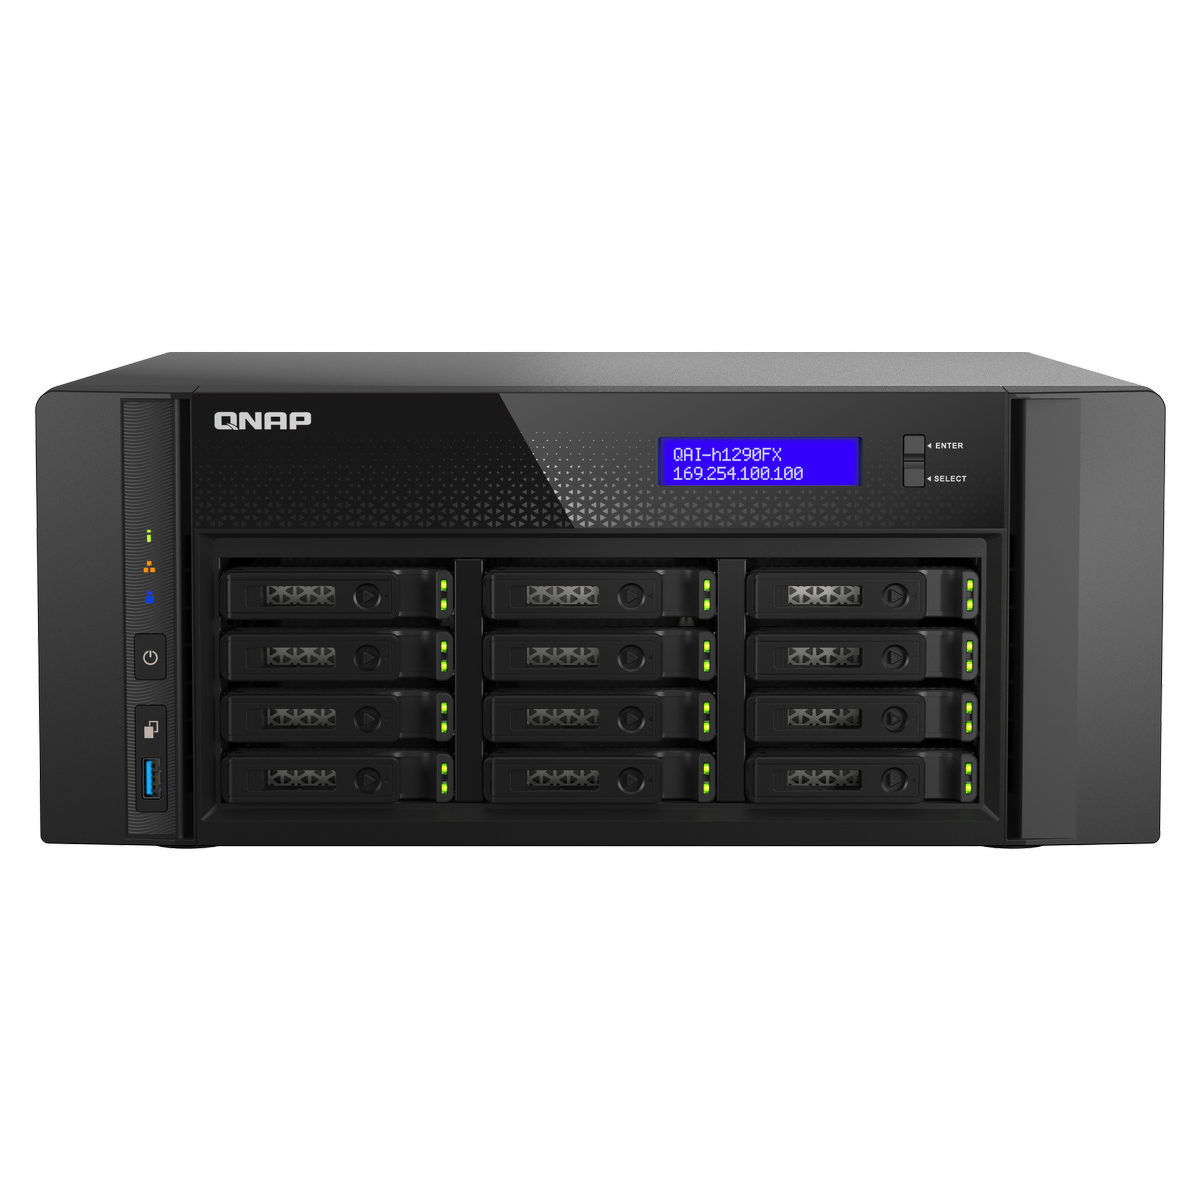
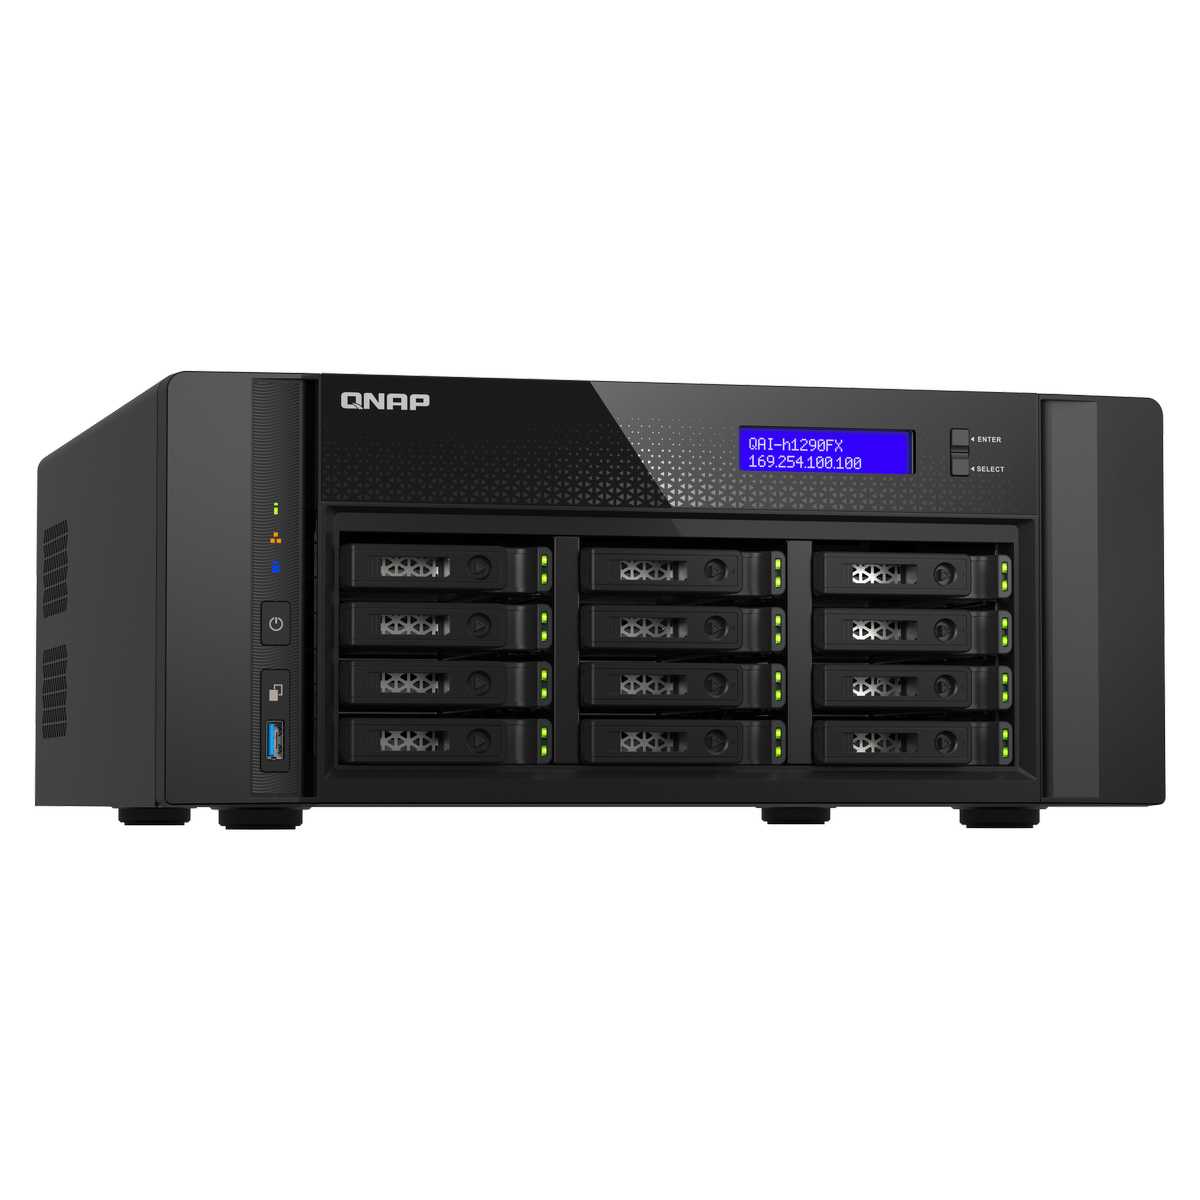


QNAP QAI-h1290FX – serwer AI z GPU do lokalnego wdrażania modeli językowych, prywatnego wyszukiwania RAG i obsługi wymagających obciążeń obliczeniowych
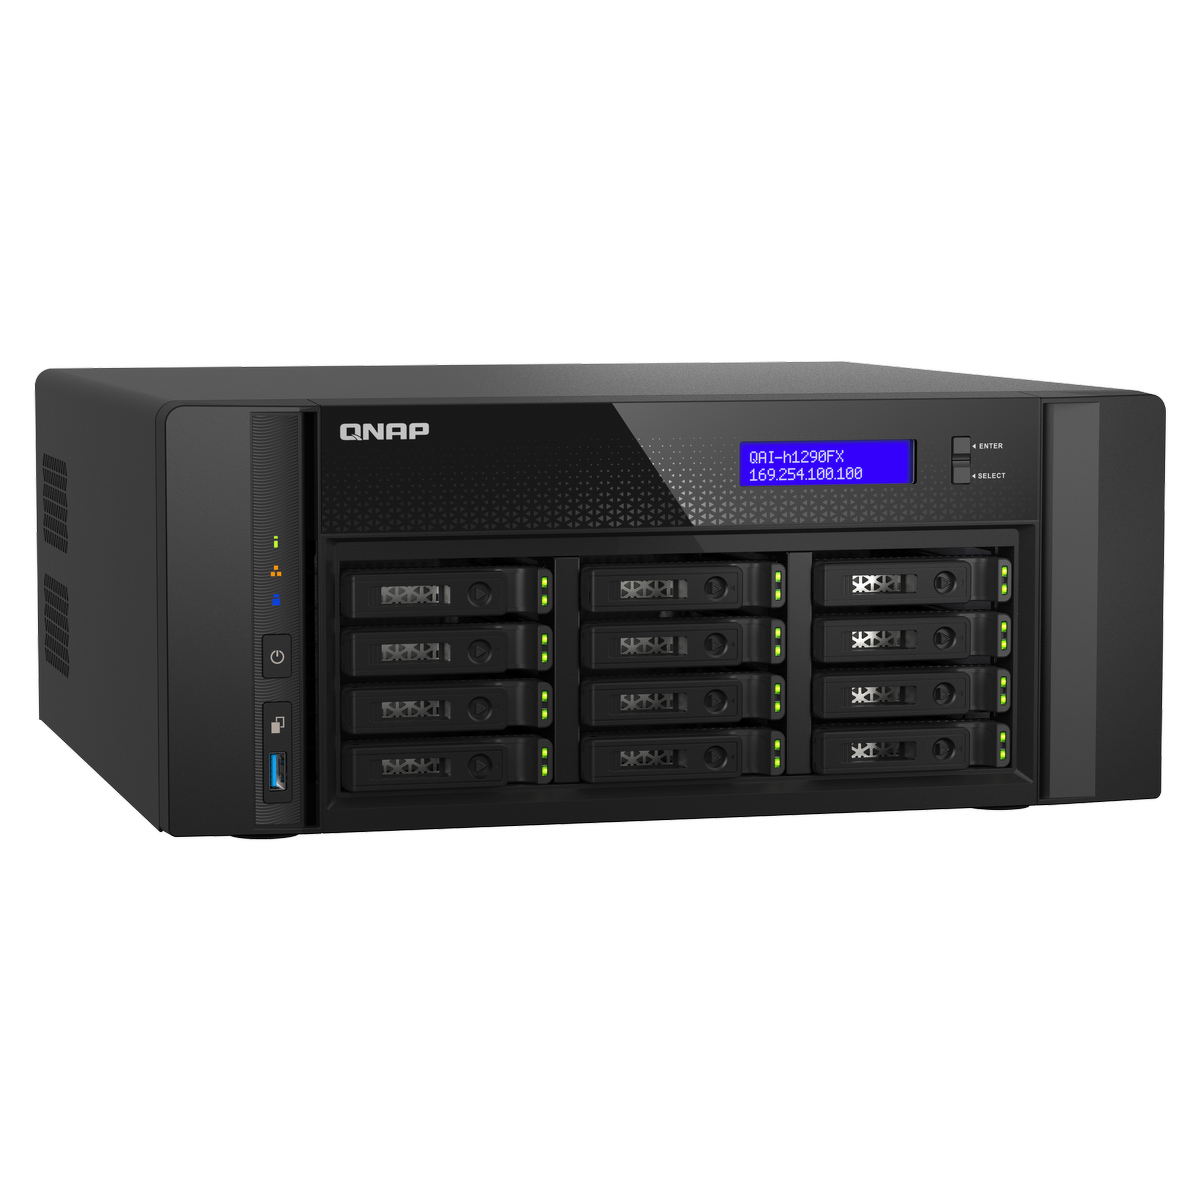
QNAP QAI-h1290FX to serwer AI w wolnostojącej, cichej obudowie, który łączy wydajną platformę obliczeniową z bardzo szybką pamięcią masową na dyskach NVMe. Powstał z myślą o firmach, które chcą uruchamiać modele językowe, generatywną AI i wirtualizację na własnej infrastrukturze — z zachowaniem prywatności i pełnej kontroli nad danymi, bez przenoszenia wrażliwych informacji do chmury.
Dlaczego warto wybrać QNAP QAI-h1290FX?
- Architektura gotowa na karty NVIDIA RTX PRO BlackwellSerwer obsługuje konfigurowalne karty NVIDIA RTX PRO Blackwell, więc poradzi sobie z wnioskowaniem dużych modeli i generowaniem obrazów.
- Lokalny LLM pod pełną kontroląModele językowe uruchamiasz na miejscu, dzięki czemu dokumenty i zapytania nie opuszczają sieci firmy.
- Wydajny procesor serwerowy AMD EPYCWysoka liczba rdzeni zapewnia stabilną pracę pod równoległymi obciążeniami AI i wirtualizacji.
- Szybka pamięć masowa na dwunastu dyskach NVMeDwanaście wnęk U.2 NVMe SSD pozwala dobrać konfigurację pod wydajność, pojemność albo koszt projektu.
- Wdrażanie aplikacji AI jednym kliknięciemGotowe szablony w Container Station pozwalają uruchomić popularne narzędzia AI bez ręcznego składania całego środowiska.
- Prywatne wyszukiwanie RAG na dokumentach firmyPytasz o treść umów i raportów w naturalnym języku, a odpowiedzi powstają lokalnie, na urządzeniu.
- Ochrona danych klasy korporacyjnejQuTS hero z systemem plików ZFS dba o integralność danych i utrudnia działanie oprogramowania szyfrującego.
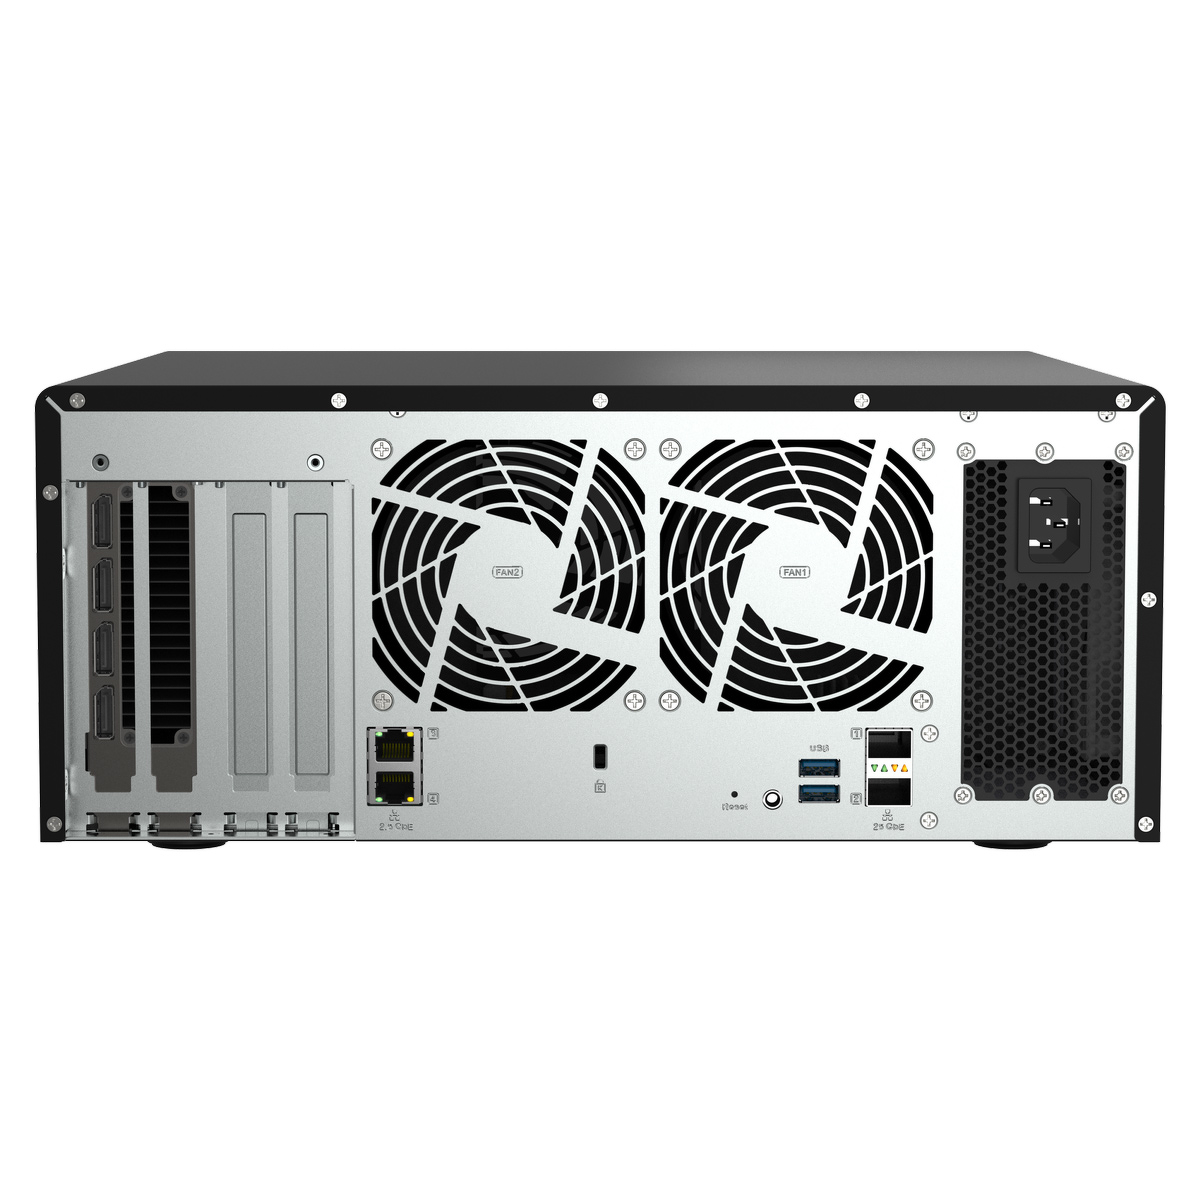
- Łączność 25GbE z zapasem na rozbudowęPodwójne porty 25GbE obsłużą szybki transfer danych, a w razie potrzeby rozbudujesz sieć aż do 100GbE.

Serwer AI z GPU gotowy na architekturę Blackwell
QAI-h1290FX zaprojektowano z myślą o obsłudze kart NVIDIA RTX PRO Blackwell, które korzystają z technologii przyspieszających CUDA, TensorRT i Transformer Engine. Taka architektura jest przygotowana pod nowoczesne obciążenia AI, od wnioskowania modeli językowych i analizy obrazu po generowanie grafiki. W opcjonalnej konfiguracji z kartą GPU serwer osiąga do 3511 AI TOPS (FP4) i 333 TFLOPS (RT Core), a gdy akceleracja GPU nie jest potrzebna, ta sama platforma pracuje jako wydajny system obliczeniowy oparty na procesorze, obsługując wirtualizację i szeroki zakres firmowych zastosowań.
Lokalny LLM i własny model bez chmury
Na tym serwerze uruchomisz model językowy lokalnie i zbudujesz własny LLM dopasowany do potrzeb organizacji, bez przekazywania danych na zewnątrz. Dla firm, którym zależy na suwerenności cyfrowej, oznacza to pełną kontrolę nad tym, gdzie i jak przetwarzane są ich dane. Sprawdza się to zarówno w projektach pilotażowych i pracy pojedynczych specjalistów, jak i w codziennym korzystaniu z asystenta AI działającego offline. Do szybkich wdrożeń wygodne jest narzędzie Ollama, a gdy pojawia się wielu użytkowników i większa liczba równoczesnych zapytań, sprawdza się wydajny silnik vLLM.
Prywatne wyszukiwanie i RAG dla firmy
Prywatne wyszukiwanie oparte na metodzie RAG łączy błyskawiczny mechanizm Qsirch z lokalnym modelem językowym, dzięki czemu pracownik otrzymuje gotową, precyzyjną odpowiedź zamiast samej listy plików. Zastosowanie RAG w firmie jest tu bardzo konkretne: przeszukiwanie umów, polityk czy dokumentacji technicznej w naturalnym języku, z odpowiedziami tworzonymi bezpośrednio na urządzeniu. To rozwiązanie na miarę potrzeb zespołów prawnych, finansowych i korporacyjnych, które nie mogą przekazywać wrażliwych treści do usług zewnętrznych.
Wydajny fundament obliczeniowy AMD EPYC
Serwerowy procesor AMD EPYC oferuje wysoką liczbę rdzeni i dużą wydajność wielowątkową, a przy tym jest przygotowany do długotrwałej, stabilnej pracy. W wersji podstawowej serwer wyposażono w 128 GB pamięci RDIMM DDR4 ECC, którą wraz z rosnącymi obciążeniami można rozbudować aż do 1 TB. Dzięki temu zadania AI, wirtualizację i przetwarzanie danych obsługujesz na jednej maszynie, zamiast utrzymywać kilka osobnych urządzeń.
Wydajna pamięć masowa na dyskach NVMe
Konfiguracja z dwunastoma wnękami U.2 NVMe SSD trafia w potrzeby firm, które szukają wydajnego, dwunastodyskowego serwera nastawionego na zadania AI. Pamięć oparta wyłącznie na dyskach SSD skraca czas dostępu do dużych plików modeli i zbiorów treningowych, co bezpośrednio przekłada się na tempo wnioskowania oraz przetwarzania danych w czasie rzeczywistym. Dyski dobierzesz elastycznie, równoważąc wydajność, pojemność i budżet.
Proste wdrażanie AI w kontenerach
Container Station obsługuje kontenery Docker i LXD, a moc GPU przypisujesz do kontenera prostym wyborem karty z listy, bez ręcznej konfiguracji sterowników. Gotowe szablony pozwalają uruchomić między innymi narzędzia AnythingLLM, OpenWebUI, ComfyUI, n8n czy Whisper, a trwałe woluminy sprawiają, że modele i dane przetrwają aktualizację lub ponowne utworzenie kontenera. W praktyce oznacza to szybsze wejście w AI i mniej czasu traconego na przygotowanie środowiska.
Integralność danych z systemem QuTS hero i ZFS
QuTS hero korzysta z systemu plików ZFS, który samodzielnie wykrywa i naprawia ciche uszkodzenia danych, chroniąc ich spójność w tle. Do tego dochodzą migawki i technologia SnapSync, niezmienne foldery WORM utrudniające działanie oprogramowania szyfrującego, ochrona niezapisanych danych na wypadek awarii zasilania oraz opatentowany algorytm QSAL, który zapobiega jednoczesnej awarii dysków SSD w macierzy. Kompresja i deduplikacja danych pomagają przy tym rozsądnie gospodarować pojemnością.
Dostęp zdalny do lokalnej AI
QNAP udostępnia kilka bezpiecznych dróg połączenia z serwerem spoza biura: dostęp przez własną domenę dzięki myQNAPcloud DDNS, połączenie pośredniczące myQNAPcloud Link bez otwierania portów oraz szyfrowany tunel przez usługę QVPN. Dzięki temu dostroisz konfigurację modelu, przejrzysz zapisy pracy albo popracujesz z innej lokalizacji, wciąż zachowując kontrolę nad środowiskiem. Lokalna AI pozostaje dostępna wtedy, gdy jej potrzebujesz, bez rozluźniania zasad bezpieczeństwa.
Cicha praca i wieloletnie wsparcie
Serwer pracuje na tyle cicho, że postawisz go w biurze lub studiu, bez wydzielania osobnego pomieszczenia czy szafy montażowej. W standardzie obejmuje go pięcioletnia gwarancja, co ułatwia planowanie i ogranicza ryzyko związane z wieloletnią eksploatacją ważnego sprzętu. Otrzymujesz jedno urządzenie, które łączy funkcje serwera AI i pamięci masowej w przewidywalnej, spójnej platformie.
Dane techniczne:
- Procesor: serwerowy AMD EPYC (architektura o wysokiej liczbie rdzeni i wielowątkowości)
- Pamięć: 128 GB RDIMM DDR4 ECC, z możliwością rozbudowy do 1 TB
- Obsługa GPU: konfigurowalne karty NVIDIA RTX PRO Blackwell, m.in. RTX PRO 6000 Blackwell Max-Q Workstation (96 GB GDDR7 ECC) oraz RTX PRO 4500 Blackwell (32 GB GDDR7 ECC)
- Technologie GPU: CUDA, TensorRT, Transformer Engine
- Maks. wydajność AI (opcjonalna konfiguracja GPU): 3511 AI TOPS (FP4), 333 TFLOPS (RT Core)
- Wnęki dysków: 12 x U.2 NVMe SSD, obsługa dysków SATA SSD, pamięć oparta wyłącznie na dyskach SSD
- System operacyjny: QuTS hero (system plików ZFS)
- Ochrona danych: samonaprawa ZFS, migawki, SnapSync, niezmienność WORM, ochrona danych przy awarii zasilania, algorytm QSAL, kompresja i deduplikacja danych
- Sieć: 2 x 25GbE, 2 x 2.5GbE, możliwość rozbudowy do 100GbE
- Rozbudowa pojemności: obsługa macierzy rozszerzających QNAP
- Dostęp zdalny: myQNAPcloud DDNS, myQNAPcloud Link, QVPN
- Aplikacje AI: Container Station (Ollama, AnythingLLM, OpenWebUI, ComfyUI, Stable Diffusion, n8n, Whisper), Qsirch, lokalne wyszukiwanie RAG
- Konstrukcja: wolnostojąca obudowa, cicha praca
- Gwarancja: 5 lat w standardzie
Wyświetlane są wszystkie opinie (pozytywne i negatywne). Nie weryfikujemy, czy pochodzą one od klientów, którzy kupili dany produkt.